先说一个我今天才发现的事。
我在这个博客里搜索“注意力”,一共命中 21 篇。最早的一篇是 2005 年 4 月 19 日,标题叫《你的博客能赚大钱吗?透视 Blog 的商业未来》,全文不到 400 字。里面有一句:
所以我觉得这个东西也不过是一个吸引眼球的东西,也就是所说的注意力经济,注意力上来了,品牌效应就出来了,最终利润来源还是广告。
那时候“注意力”是我的说法:人的注意力,能变成广告钱。
2017 年 6 月,Google 的八个人发表了一篇论文,把同一个英文词 attention 用在了机器身上。
(附带一个我自己找了半天才想通的事:我博客里“注意力”命中 21 篇,但 2017 年之后那几篇都不是论文——2024 年 7 月 29 日是一条链接标题“vLLM 源码之 PagedAttention”,2025 年 2 月 19 日是“Native Sparse Attention”。两次都是关于怎么少算点。所以我最早是从“让它省点算力”这个角度撞见机器学习里的 attention 的,不是在“它怎么思考”这个角度。)
我读这篇的时候,脑子里卡住的地方就在这儿:他们说的“注意力”,是“它注意到了”(像人),还是“权重”(像算术)?
如果是前者,那这个词就是在吹牛;如果是后者,那它为什么叫注意力,不叫“加权”?
一、我先去找原始的那篇论文
论文是《Attention Is All You Need》,2017 年 6 月 12 日挂到 arXiv 上(编号 1706.03762),后来收在 NeurIPS 2017。作者八个:Ashish Vaswani、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan N. Gomez、Łukasz Kaiser、Illia Polosukhin。
论文里那个核心公式长这样:
论文自己给出的解释比我预想的朴素。3.2.1 节原句:
The output is computed as a weighted sum of the values, where the weight assigned to each value is computed by a compatibility function of the query with the corresponding key.
(输出是所有 value 的加权和;每个 value 的权重,由 query 和对应 key 的“相容程度”算出来。)
Google 的博客说得更白,那是 2017 年 8 月 31 日的一篇科普稿,原句:
The attention scores are then used as weights for a weighted average of all words' representations.
(注意力分数被当作权重,对所有词的表示做加权平均。)
加权平均。 就是这么回事。
那为什么叫“注意力”?论文里没解释命名,Google 的博客也没解释。我猜是因为它像:每个词都在问所有词“你跟我有多相关”,然后按相关程度,把大家抄一遍给自己。
还有一处细节我一开始没看懂:那个 √d_k 是干什么的。论文给的理由是(我把它抄在这里,因为这个理由本身很说明问题):
We suspect that for large values of d_k, the dot products grow large in magnitude, pushing the softmax function into regions where it has extremely small gradients. To counteract this effect, we scale the dot products by 1/√d_k.
(我们怀疑,当 d_k 很大时点积会变得很大,把 softmax 推进梯度极小的区域;为了抵消这个,我们把点积除以 √d_k。)
也就是说:分数太极端的时候,softmax 会“塌陷”,训练就卡住。缩放是为了让它待在那个不塌陷也不饱和的区间里。这是个纯工程上的补丁——说明“注意力”不是某一天想出来的哲学,它是调出来的。
二、我自己写了一个最小的
读完我还是没懂。那就自己写一个。
我用纯 Python 写了三十来行,不用 numpy,就三步:算点积、softmax、加权平均。
输入用我自己的话——就是 2023 年 8 月 2 日那句「有了 AI 之后,不用再保存自己写过的代码了」,我按字切成 17 个词:
有了 · AI · 之 · 后 · 不 · 用 · 再 · 保 · 存 · 自 · 己 · 写 · 过 · 的 · 代 · 码 · 了
词向量是我自己手写的三个轴:x 轴是“跟代码技术有关”,y 轴是“跟时间记忆有关”,z 轴是“跟情绪态度有关”。比如“AI”和“码”都是 (1, 0, 0),“自”和“己”是 (0, -0.2, 1),我瞎编的,不是训练出来的。
跑出来的结果,第一件事就让我意外:
没有一个词被挑中。
我原以为注意力是“挑出重点词”,结果每个词都参与了,只是权重不同。整张表里最重的两个权重是 0.131 和 0.129(「自」抄「自」和「己」),最轻的是 0.037——没有任何一个词是 0。连“之”这种几乎不携带意义的字,都被别的词以 0.062 的权重抄进了平均值里;它自己那一行,几乎是一串 0.06。
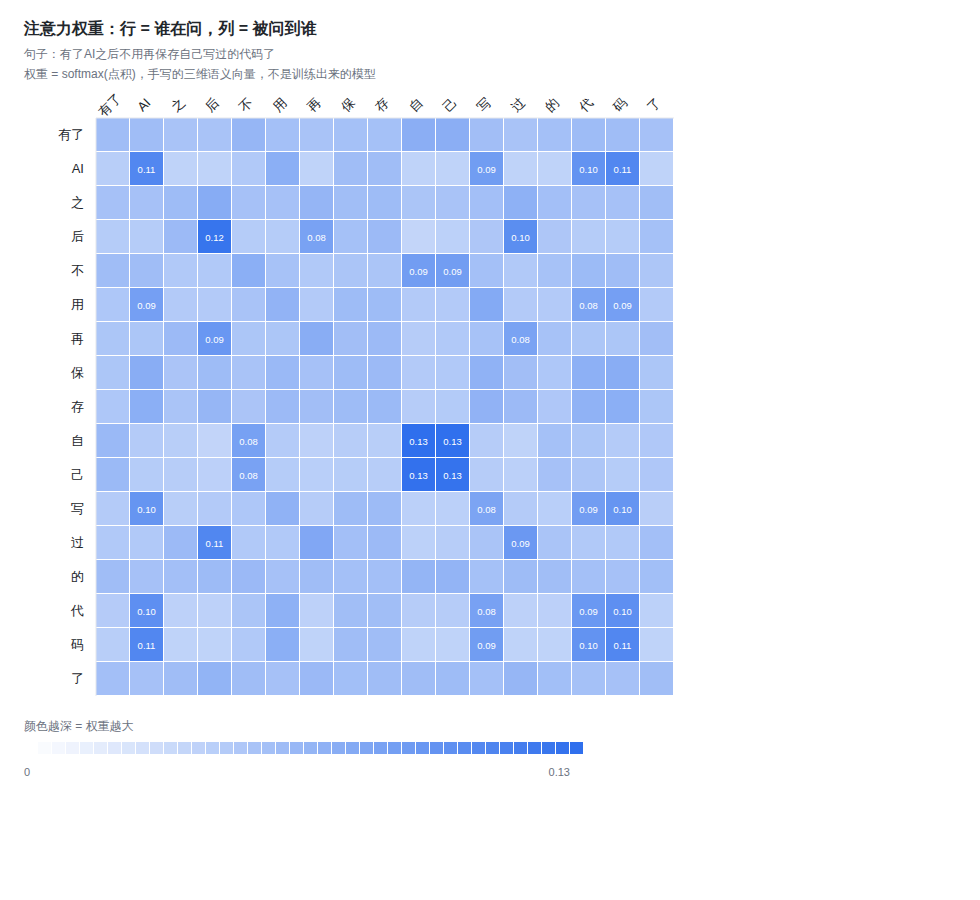
更有意思的是“码”这个词。它原来的向量是 (1, 0, 0),纯粹是“技术”。做完加权平均之后:
它被稀释了。技术那一条轴从 1.0 掉到 0.478,位置那一轴和时间那一轴都上来了——因为“不用再保存”这句话里,还有“不”“再”“后”“了”这些带着时间和态度的词。
这就是注意力在干的事:它把上下文抄进词里,把词改造成“在这句话里的这个词”。
还有一个我自己踩到的坑。论文说那个 √d_k 是为了防止 softmax 太尖锐;可在我的脚本里,加了缩放之后权重反而更平了——“自”原本最高的权重是 0.131,除以 √3 之后掉到 0.096,整张表都趋向了平均值。
方向正好相反。我想了半天才明白:论文担心的场景是维度大、点积大;我手编的三维向量分数天生就小,除一下当然更平。缩放不是随手加上的常数,它是用来把 softmax 按在“不塌陷也不饱和”的那个区间里;往哪边挪,得看你的向量有多大。
三、真正被学会的,其实是“猜下一个词”
Transformer 是 2017 年 6 月的东西,但真正让人写代码时用上它的,不是论文,是后面那串东西:GPT-1(2018 年 6 月)、GPT-2(2019 年 2 月,15 亿参数)、GPT-3(2020 年 5 月,1750 亿)、InstructGPT(2022 年 3 月)、ChatGPT(2022 年 11 月 30 日)。
这一串我以前只是记着日期,不知道它们之间是什么关系。直到看到 Scaling Laws 那篇(2020 年 1 月):loss 随模型规模、数据量和算力呈幂律下降。以及 Chinchilla 那篇(2022 年 3 月)的结论——每把模型规模翻一倍,训练用的 token 数也应该翻一倍,而且“current large language models are significantly undertrained”。
于是“学会写字”这件事被拆成了两半:
- •Transformer 提供机制:怎么把上下文抄进词里。
- •规模提供内容:用天文数字的文本,反复练同一件事——猜下一个词。
写字的过程也就清楚了:给一句话,模型给出下一个词的概率分布,采一个,接在后面,再算一遍,循环。它不是在“写”,它是在不停地“接下一个词”。
这里有个我以前一直将信将疑的地方:所谓的“忽然会了某件事”。Wei 等人在 2022 年 6 月提出“涌现能力”,说大模型会出现小模型没有的能力。但 Schaeffer 等人(2023 年 4 月,斯坦福)反驳说,这多半是研究者选的尺子造成的错觉,原句是 “emergent abilities appear due the researcher's choice of metric rather than due to fundamental changes in model behavior with scale”。BIG-bench 论文里那句更具体:
The exact_str_match metric can lead to apparent sudden breakthroughs because of its inherent all-or-nothing discontinuity.
(“完全匹配”这个指标本身是全有全无的,所以会让平滑的进步看起来像突然的突破。)
所以我现在的说法是:它到底是某天突然会了,还是一直在变好、只是我的尺子在某处跳了一格,我说不准。 这件事我到现在也没想明白。
四、注意力很贵,而我早就抱怨过
原论文的复杂度表里,自注意力那一行写着 O(n²·d)。翻译成人话:每个词都要问每个词一句话,句子长度翻一倍,计算量翻四倍。
后来的人一直在修:Longformer(2020 年 4 月)让长文本的注意力线性增长;FlashAttention(2022 年 5 月)和 FlashAttention-2(2023 年 7 月)不改数学,只改怎么算;Mamba(2023 年 12 月)和 Mamba 2(2024 年 5 月)干脆想换架构。
而这些,我不用查——我自己在 2025 年 8 月 16 日就写过一篇《AI 的影响》,里面正好有一段抱怨:
如果代码文件特别长,问题又牵扯到文件里其他地方的东西,它有时候就答不对了。感觉它记不住太多上下文,太复杂了就迷糊。
我 2025 年抱怨的这件事,2023 年的论文里就写明白了:上下文一长,它就记不住。
这句话我想多停一下。我不是靠读论文想明白的,是靠天天用它、用了两年、然后自己撞墙撞出来的。论文写的是代价,我写的是撞墙。 这两件事中间隔着两年的日常。
五、我也拿这套形状,读了我自己的博客
既然注意力是“对每个东西打分,然后加权”,那我就用它读读我自己。
具体做法很土:我用词频和标题加权当打分函数,对每一篇文章算分,取最高的。我很清楚这不是注意力——真模型的打分来自学出来的向量,我这儿只有数词频。它是注意力的穷亲戚,检索而已。
我用它问了三个问题。(下面的日期是我读到这些的那一天;我的每日汇总通常第二天早上才发出去。)
问“AI + 代码 + 写”,翻出来的是:
- •2025-08-16《AI 的影响》(就是上面那篇)
- •2007-11-15《改写代码,让 Gmail 走向未来》
- •2011-04-02 的一句:“奶奶的,当年写的代码基本上全看不懂了”
问“Copilot + 代码 + 自动”,翻出来的是 2023 年 3 月 24 日那篇 Copilot X 的汇总、2023 年 8 月 27 日的 Codeium、2024 年 10 月 5 日的 Cursor 与 Copilot Workspace 对比。
最让我愣住的是另外两句,都是它顺手翻出来的,我自己早忘了:
- •2023 年 7 月 19 日:「看来,写程序能让我平静下来。」
- •2023 年 8 月 24 日:「突然发觉,近些年唯一让觉得眼前一亮的软件技术似乎只有 ChatGPT」
这两句夹在 8 月 2 日那句话前后。8 月 2 日我说“不用再保存自己写过的代码了”,8 月 24 日我说“唯一让我眼前一亮的似乎只有 ChatGPT”。 中间的那个月,我不是没用它,我是在慢慢才反应过来它是什么。
还有一句是 2011 年的:“奶奶的,当年写的代码基本上全看不懂了。”那是我 2011 年写的,写的时候完全不知道十二年后会有这么一台机器。
这台“机器”不会写、不会推理、不会理解,它只是数词频。但它做对了一件事:它比我自己的记忆更诚实。 它能翻出我 2007 年和 2011 年的句子,而我早就忘了。
六、我还没懂的
第一,权重是谁给的。
没有人写“代码该关注保存”。这些权重是训练出来的——模型猜错下一个词,就回传一点误差,权重挪一点,挪到几百万亿次之后,它们就“知道”了。
没人教它什么叫有用,它怎么就知道? 这一点我到现在也没想明白。
第二,多层叠加之后,“相关性”变成了什么。我跑的是一层、一个头、三维手写向量。真实的模型有几十层,每层几十个头,维度是几千。它们叠起来之后,“相关性”还是我理解的那个相关性吗?
第三,也是我最想问的:它读到「有了 AI 之后,不用再保存自己写过的代码了」这句话的时候,是不是和我读到它时一样。
如果一样,那我这两年对它的态度就太自恋了——我以为是我在用它,其实是它在我读它。
最后还有个更笨的:“注意力”这个词是从人脑借来的。我们借它,只是因为它听起来像我们理解世界的方式。 至于它到底在干什么,我们其实是用了一个心理学名词,包装了一次矩阵乘法。
七、下一期
注意力机制 2017 年 6 月就写出来了,可它又等了五年,才变成人人都会用的东西(2022 年 11 月 30 日,ChatGPT)。
这五年里缺的不是技术。缺的是:一个人人同意的名字、一群人、一份预算、一个能收学生发论文的领域、一套让人愿意往里钻的秩序。
所以我下一期想从有名的地方开始:“人工智能”这个词,是谁、在哪一年、为了什么给它的?
1956 年那个夏天,达特茅斯。

没有评论:
发表评论