上一期我算了一笔账:训练一次 BLOOM 烧掉的电,够我家那台机器开 330 年。
写完我有点心虚。因为那笔账算的是训练——一件发生过一次的事。
而真正每天都在发生的是推理:几十亿次提问、几十亿次回答,每一次都要占着机器、烧着电。
于是这一期我想问一个很具体的问题:
一次聊天机器人回答,凭什么要花电?它要花多少?谁在付?
我照惯例,先去翻自己的博客。因为我发现,我跟电的关系,比我以为的早得多。
一、我在 2005 年就因为电费放弃过一次写博客
脚本在 实验/electricity_words.py,数据在 记录/electricity_words.json。扫 9187 篇导入文章,先去掉 URL 和长串编码,再按词匹配。
| 词 | 第一次出现在我的博客里 | 那一篇 |
|---|
| 服务器 | 2004-02-13 | 《@ 通过代理使用apt》 |
| 电费 | 2005-04-19 | 《你的博客能赚大钱吗?透视Blog的商业未来》 |
| 数据中心 | 2007-11-20 | 《摘要输出和全文输出》 |
| 耗电 | 2011-04-19 | Twitter Daily |
| 功耗 | 2011-07-01 | Twitter Daily |
| 度电 | 2014-01-04 | Twitter Daily |
| 机柜 | 从未出现 | — |
| 风电 / 光伏 / 电表 / 限电 | 从未出现 | — |
第一次写"电费"的那篇,标题是《你的博客能赚大钱吗?》——里面那段原话是:
其实很就以前就开始xieblog了,那时还是用自己的服务器写的,使用的是一个叫weblig的程序,后来由于电费太贵就算了(因为我当时是使用adsl在自己家里作的)
("xieblog" 是我当年的错别字,原样保留。)
也就是说:我第一次在博客里写"电费",是因为电费让我写不成博客。家用 ADSL 跑自己的服务器,电费扛不住,就停了。
再往后还有几句:
2013-01-07 @dahuang8 NND,我每个月的电费也要30美刀了。
2018-06-24 买个功率计看看各种电子设备到底功耗如何。
2022-02-18 平均功率70瓦,一天一度电的样子
2022-03-24 一天两度电的自组HomeLab(NAS)也算是高功耗了吧。
2018 年我买过一台功率计。 六年以后,全世界都在讨论 AI 的电费,而我八年前就在自己家里量冰箱和 NAS。
顺带交代误差:这些"我自己写的行"里还混着不少转推(脚本已经过滤 RT @ 和纯链接标题),而且"服务器"那 22 年里大部分是代理服务器、翻墙服务器,跟耗电没关系。
二、给我的机器装一块"电表"
第 09 期我在自己博客上训练了一个 n-gram 小模型。那一期我只看了准确率和困惑度。
这一期我回头给它加一样东西:能耗。
麻烦在于,我这台笔记本没有 RAPL 计数器,电池插着电也读不到市电,我也没有插座功率计。
所以我只能退一步:用 CPU 时间 × 官方 TDP 算一个上界。我的机器是 i9-12900H,Intel ARK 上标的基础功率是 45 W。满载假设,所以实际值更低。
| 动作 | CPU 时间 | 墙钟时间 |
|---|
| 读完 9186 篇博客(导入镜像) | 2.877 s | 3.254 s |
| 切成 150 万个词(我自己的切法) | 0.303 s | 0.303 s |
| 训练一次 3-gram 模型(第 09 期那个) | 4.537 s | 4.543 s |
| 算困惑度和准确率 | 6.305 s | 6.321 s |
| 在账本里做一次全文检索("功率计") | 0.005 s | 0.010 s |
| 合计 | 14.027 s | 14.431 s |
14.0 秒 CPU 时间 × 45 W = 0.631 Wh 上界。
(单次运行的数字,重跑会有几秒出入;表格里的绝对值会变,量级不会。)
对照我自己 2022 年那台 NAS:一天一度电。
所以:读完我 22 年的博客、训练一个模型、算出困惑度——这件事的耗电上界,不到我家 NAS 一天的 1/1500。
这个数字小得让我有点难堪。因为它太小了。
三、给我自己这一期开一张发票
机器那一侧测完了,我再量一次模型那一侧——用我自己真实的调用。
我做了 12 次调用(脚本 实验/ai_invoice.py):9 段取自我自己博客的真实原文,每段前 1200 字,让模型用两句话概括;再加 3 个固定的短问题。每次都记录 API 返回的 input_tokens、output_tokens、thinking_tokens。
| 项目 | 数字 |
|---|
| 调用次数 | 12 |
| 输入 token | 4,363 |
| 输出 token | 2,383(其中思考 token 1,839) |
| 官方单价(M3.1-Flash,中文站) | 输入 1.00 元 / 百万 tokens,输出 4.00 元 / 百万 tokens |
| 总费用 | 0.0139 元 |
| 单次普通问答 | 约 0.0007 元 |
| 处理 1200 字原文并概括 | 约 0.0015 元 |
0.0139 元。 不到两分钱。分摊到 12 次,一次不到一厘钱。
顺手验证了一件事:官方定价页写"1600 中文字符约消耗 1000 tokens"。我不信这个估算,用自己那 9 段原文的实测 token 数复算:
| 口径 | tokens / 千字符 |
|---|
| 官方 | 625 |
| 我的实测(9 段真实原文,扣掉提示词开销) | 613.4 |
差 1.8%。官方口径在我自己的中文文本上基本准确。
那就可以算一个更大的数:读完我 22 年的博客(301 万字符):
- •输入约 185 万 tokens → 1.85 元
- •若让模型把它全部重写一遍 → 再加 7.39 元
- •合计 9.24 元
9.24 元,大约是我家 1.4 天的电费。(按我第 11 期沿用的假设:0.6 元/度、一年 1314 度。)

这里出现了一个让我停下来的对照:
| 电 | 钱 |
|---|
| 我自己的机器读完 + 训练一遍 | 0.63 Wh 上界(约 0.38 分钱电费) | 0 |
| 模型读完并重写一遍 | 官方没公布(1.85 元里电占多少,无从得知) | 9.24 元 |
我的机器省下的是 5000 倍。
但这个结论是假的,而且我知道它为什么假:我的机器本来就在开着。 它已经开了二十二年了,那 14 秒的边际电费几乎是零。而模型的每一次对话,都是从头开始付。
第 08 期我说过一句:AlphaGo 不是"从零开始",是"从棋盘开始"。模型也一样——它不是从零开始付电,它是从零开始付。
四、官方到底怎么说"一次对话要多少电"
我自己测的是我自己的调用。要谈这一行,得看官方的数。而官方的数,比我想象的少。
目前有"厂商官方 + 论文"双份出处的,只有 Google 一家。 2025 年 8 月 22 日,Google Cloud 官方博客(作者是 Amin Vahdat 与 Jeff Dean):
Using this methodology, we estimate the median Gemini Apps text prompt uses 0.24 watt-hours (Wh) of energy, emits 0.03 grams of carbon dioxide equivalent (gCO₂e), and consumes 0.26 milliliters (or about five drops) of water — figures that are substantially lower than many public estimates. The per-prompt energy impact is equivalent to watching TV for less than nine seconds.
配套论文 arXiv:2508.15734 里还有一句:
However, no studies have measured AI serving environmental metrics in a production environment.
这是第一次在真实生产环境里量过 AI 服务端的能耗。 0.24 瓦时——比看 9 秒电视还少。
同一篇博客也给了"乐观口径",只算加速器主动功耗,是 0.10 瓦时;而全栈口径(加上空闲容量、主机 CPU 和内存、冷却配电)才是 0.24 瓦时。还有一个容易被忽略的好消息:
over a recent 12 month period, the energy and total carbon footprint of the median Gemini Apps text prompt dropped by 33x and 44x, respectively
一年内,中位提示的能耗降了 33 倍。 效率这条线在跑。
学术界那边,Luccioni 等人的《Power Hungry Processing》(arXiv:2311.16863)测得更细:
| 任务 | 平均能耗(kWh / 1000 次) |
|---|
| 文本分类 | 0.002 |
| 文本生成 | 0.047(≈ 0.047 Wh / 次) |
| 摘要 | 0.049 |
| 图像描述 | 0.063 |
| 图像生成 | 2.907(≈ 2.907 Wh / 张) |
图像生成比文本生成贵约 60 倍。 而且同一篇论文里还有一句更让人在意的:做同样的任务,不同的模型能耗能差 1450 倍。
2026 年 1 月,Microsoft Research 与 ML.Energy 在 Joule 上发了目前规模最大的一次实测(arXiv:2601.22076):46 个模型 × 7 类任务 × 1858 种配置,跑在 H100 和 B200 上。里面有一句:
Generating a single video consumes 26 kJ to 1.16 MJ—one to two orders of magnitude more than images.
生成一个视频,比生成一张图贵一到两个数量级。
然后是最要紧的部分:谁没给数。
- •OpenAI 没有给。 官方教学页上写着:"While proprietary energy benchmarks for models like GPT-4 aren't yet published…";同一页还顺手纠正了网上流传的说法——"Some claims circulating online suggest that a single ChatGPT query consumes up to 3 watt-hours of electricity. But those figures are often based on speculation and outdated assumptions."
- •Anthropic 没有给。 没有 per-query 的能耗数字,只有"美国 AI 未来数年至少需要 50 GW 容量"这种量级表态。
- •Meta 没有给。 Llama 3 的论文和模型卡里都没有能耗或碳排数字。
所以"AI 一次对话要多少电"这个问题,官方答案是:只有 Google 一家给了,其它家都没有。 我上面引的 0.24 瓦时,是目前唯一能引用的"厂商官方 + 生产环境实测"数字。
顺便清几条我记错的(这几条我在核对报告里逐条查过):
- •我一直以为 Google 在 2024 年 5 月发过一篇推理能耗的官方博客——没找到,最早的一手是 2025-08-22 那篇。
- •"训练 GPT-3 需要 1287 MWh"——数字对,但原文写的是 "estimated",是 Patterson 等人 2021 年的推算,不是实测。
- •"AI 占全球用电 1.5%"——口径错了。1.5% 是数据中心全部用电,不是 AI 专属。
- •"到 2030 年占 5%"——找不到官方支持。IEA 的 5% 指的是新兴经济体用电增量里的占比。
- •Llama 3 论文里没有碳排一节(这次取得的 PDF 与 HTML 全文里 0 处 carbon / emission)。
五、钱的那一面
单次很便宜。那这行的总账长什么样?
先看价格(都是官方定价页,"一次对话"按 500 输入 + 500 输出统一假设,我按官方单价算):
| 厂商 / 模型 | 一次"对话"的价格 |
|---|
| OpenAI GPT-6 Luna | ≈ $0.0003 |
| Anthropic Haiku 5.5 | ≈ $0.0003 |
| DeepSeek deepseek-flash(离峰) | ≈ $0.000375 |
| Mistral Small 4 | ≈ $0.000375 |
| Gemini(主模型标准档) | ≈ $0.006 |
| OpenAI GPT-6.1 Sol | ≈ $0.006 |
| MiniMax M3.1-Flash(中文站) | ≈ ¥0.0025 |
一次对话不到一美分。 便宜到没人会为它停下来想。
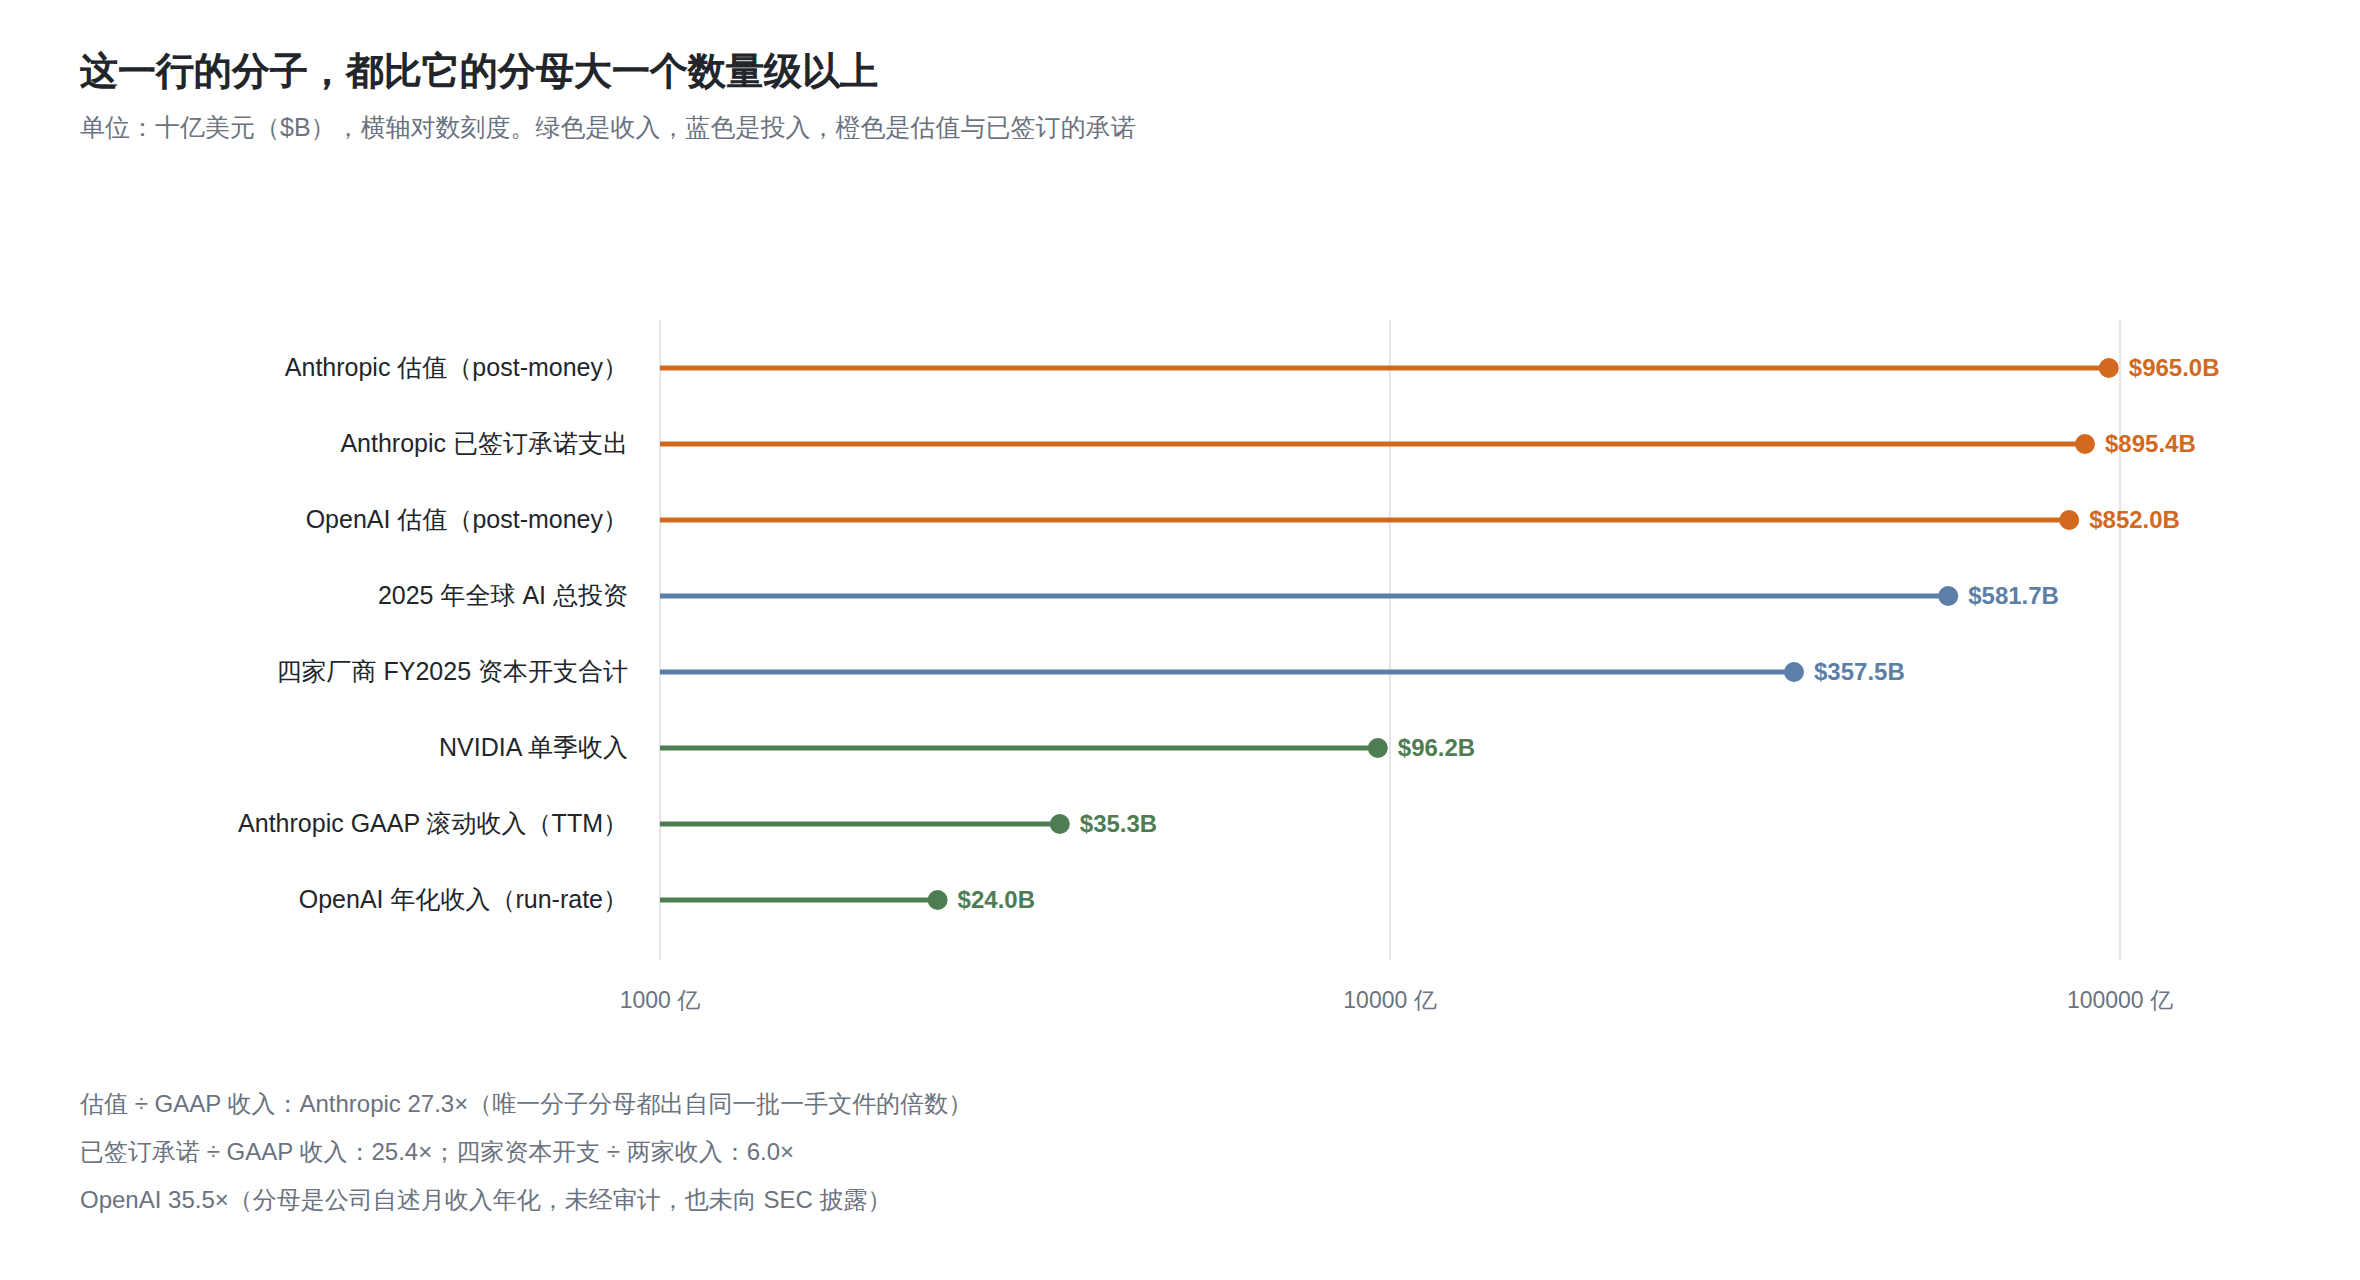
再看这一行真正花的钱(四家厂商自己财报里的数字,SEC 文件):
| 公司 | FY2024 | FY2025 | 2026 |
|---|
| Alphabet | $52.53B | $91.45B | 前三季 $131.95B |
| Microsoft | $44.48B | $64.55B | FY2026 $115.95B |
| Amazon | $83.00B | $131.82B | 前三季 $175.67B(cash capex 口径不同) |
| Meta | $37.26B | $69.69B | 全年指引 $135–145B |
Alphabet 在 2025 年的 10-K 里写得很直白:
During the years ended December 31, 2024 and 2025, we spent $52.5 billion and $91.4 billion on capital expenditures, respectively. In 2026, we expect to significantly increase, relative to 2025, our investment in our technical infrastructure, including servers and network equipment, and data centers.
Meta 在 2026 年三季度的 10-Q 里说:
We anticipate making capital expenditures of approximately $135 billion to $145 billion in 2026 to support our AI efforts and core business.
一年几千亿美元的资本开支,用来盖机房、买芯片。 这就是"一次对话只花一美分"背后的东西。
电从哪来? IEA《Energy and AI》(2025 年 4 月)的执行摘要:
Data centres accounted for around 1.5% of the world's electricity consumption in 2024, or 415 terawatt-hours (TWh). … Data centre electricity consumption is set to more than double to around 945 TWh by 2030. … In the United States, data centres account for nearly half of electricity demand growth between now and 2030.
美国的数字来自 LBNL《2025 Update》(2026 年 6 月):2024 年 192 TWh,占全美用电 4.7%;2030 年参考情形 649 TWh,占 11.8%,区间 9.5%–15.3%。 同一份报告里还有一句:
seven million units in 2024, consisting of 73% GPUs and 27% ASICs
把这些数字和我自己那 0.63 瓦时放在同一根对数轴上,那个点几乎看不见:

然后是这些电的"来源",一份份合同:
- •Constellation × Microsoft(2024-09-20 官方新闻稿):20 年购电协议,重启三里岛 1 号机组,"add approximately 835 megawatts of carbon-free energy to the grid",3,400 个岗位。
- •Talen × Amazon(2025-06-11,以 8-K EX-99.1 报送 SEC):"Talen will provide Amazon with 1,920 megawatts of carbon-free nuclear power through 2042",宾州投资 $20B。
- •Google × Kairos:500 MW。Meta × TerraPower:核能 6.6 GW。
- •Anthropic(2026-02-11 官方公告):
Anthropic will cover electricity price increases that consumers face from our data centers.
Training a single frontier AI model will soon require gigawatts of power, and the US AI sector will need at least 50 gigawatts of capacity over the next several years. … AI companies shouldn't leave American ratepayers to pick up the tab.
同一家公司在 2026 年 4 月宣布在美国自建 500 亿美元的计算基础设施。
最有意思的一组数字来自 IEA 关于"约束"的判断:
around 20% of planned data centre projects could be at risk of delays. … Building new transmission lines can take four to eight years in advanced economies and wait times for critical grid components such as transformers and cables have doubled in the past three years.
变压器等待时间,三年翻倍。输电线要修四到八年。
还有一句更狠的:
An AI-focused data centre is 10 times more capital-intensive than an aluminium smelter
六、我的判断,和我仍然不懂的
暂时形成的理解(以下是我的判断,不是官方结论):
- •"AI 很费电"这句话,在单次对话层面是错的,在行业总量层面是对的。 Google 官方实测的一次文本提示是 0.24 瓦时;同一天的用电量级是 192 TWh。两个数字都对,只是尺度差了一万亿倍。讨论时必须先说清说的是哪一个。
- •电在 2026 年大概已经不是最紧的那根弦,紧的是变压器、许可和并网排队。 一次对话便宜到可以忽略,于是这一行的竞争就变成了"谁能更快拿到电"——Constellation、Talen、Kairos、TerraPower 抢的是同一个东西。这跟第 11 期的芯片是同一种稀缺,只是换了个位置。
- •API 的价格已经不能用来推算能耗。 一分钱的对话背后是几百亿美元的资本开支和一堆核电站合同。便宜的是话,贵的还是电。
我到现在也没想明白的:
- 1.那 192 TWh 里,有多少是"AI 推理"? LBNL 说的是"数据中心",里面还有搜索、视频流、普通网站。官方口径给不出这个切分,我也不知道。
- 2.电便宜下来之后,"电够不够"还算不算约束? 如果一度电在某些地方便宜到可以忽略,那约束就变成了别的——变压器、冷却水、并网排队、居民电价。我不知道该把这件事叫"能源问题"还是"基础设施问题"。
- 3.我有没有资格谈 AI 的电费? 我自己那台开了 22 年的机器,电费到底谁付过?我在 2005 年因为电费停过一次博客,在 2022 年给 NAS 记过"一天两度电"。我连自己的电费都没算清楚过。
还有一件必须说的事:
第 11 期我为了换算 BLOOM,假设"家用机器平均 150 W"。而我自己在 2022 年就实测过"平均功率 70 瓦,一天一度电"。 那一期我应该先翻自己的博客再假设。
下一篇:这是不是一场泡沫
写完这一期,我最强烈的感受是:这一行的账单已经大到不正常了,但我还没法判断它是不正常,还是只是变大。
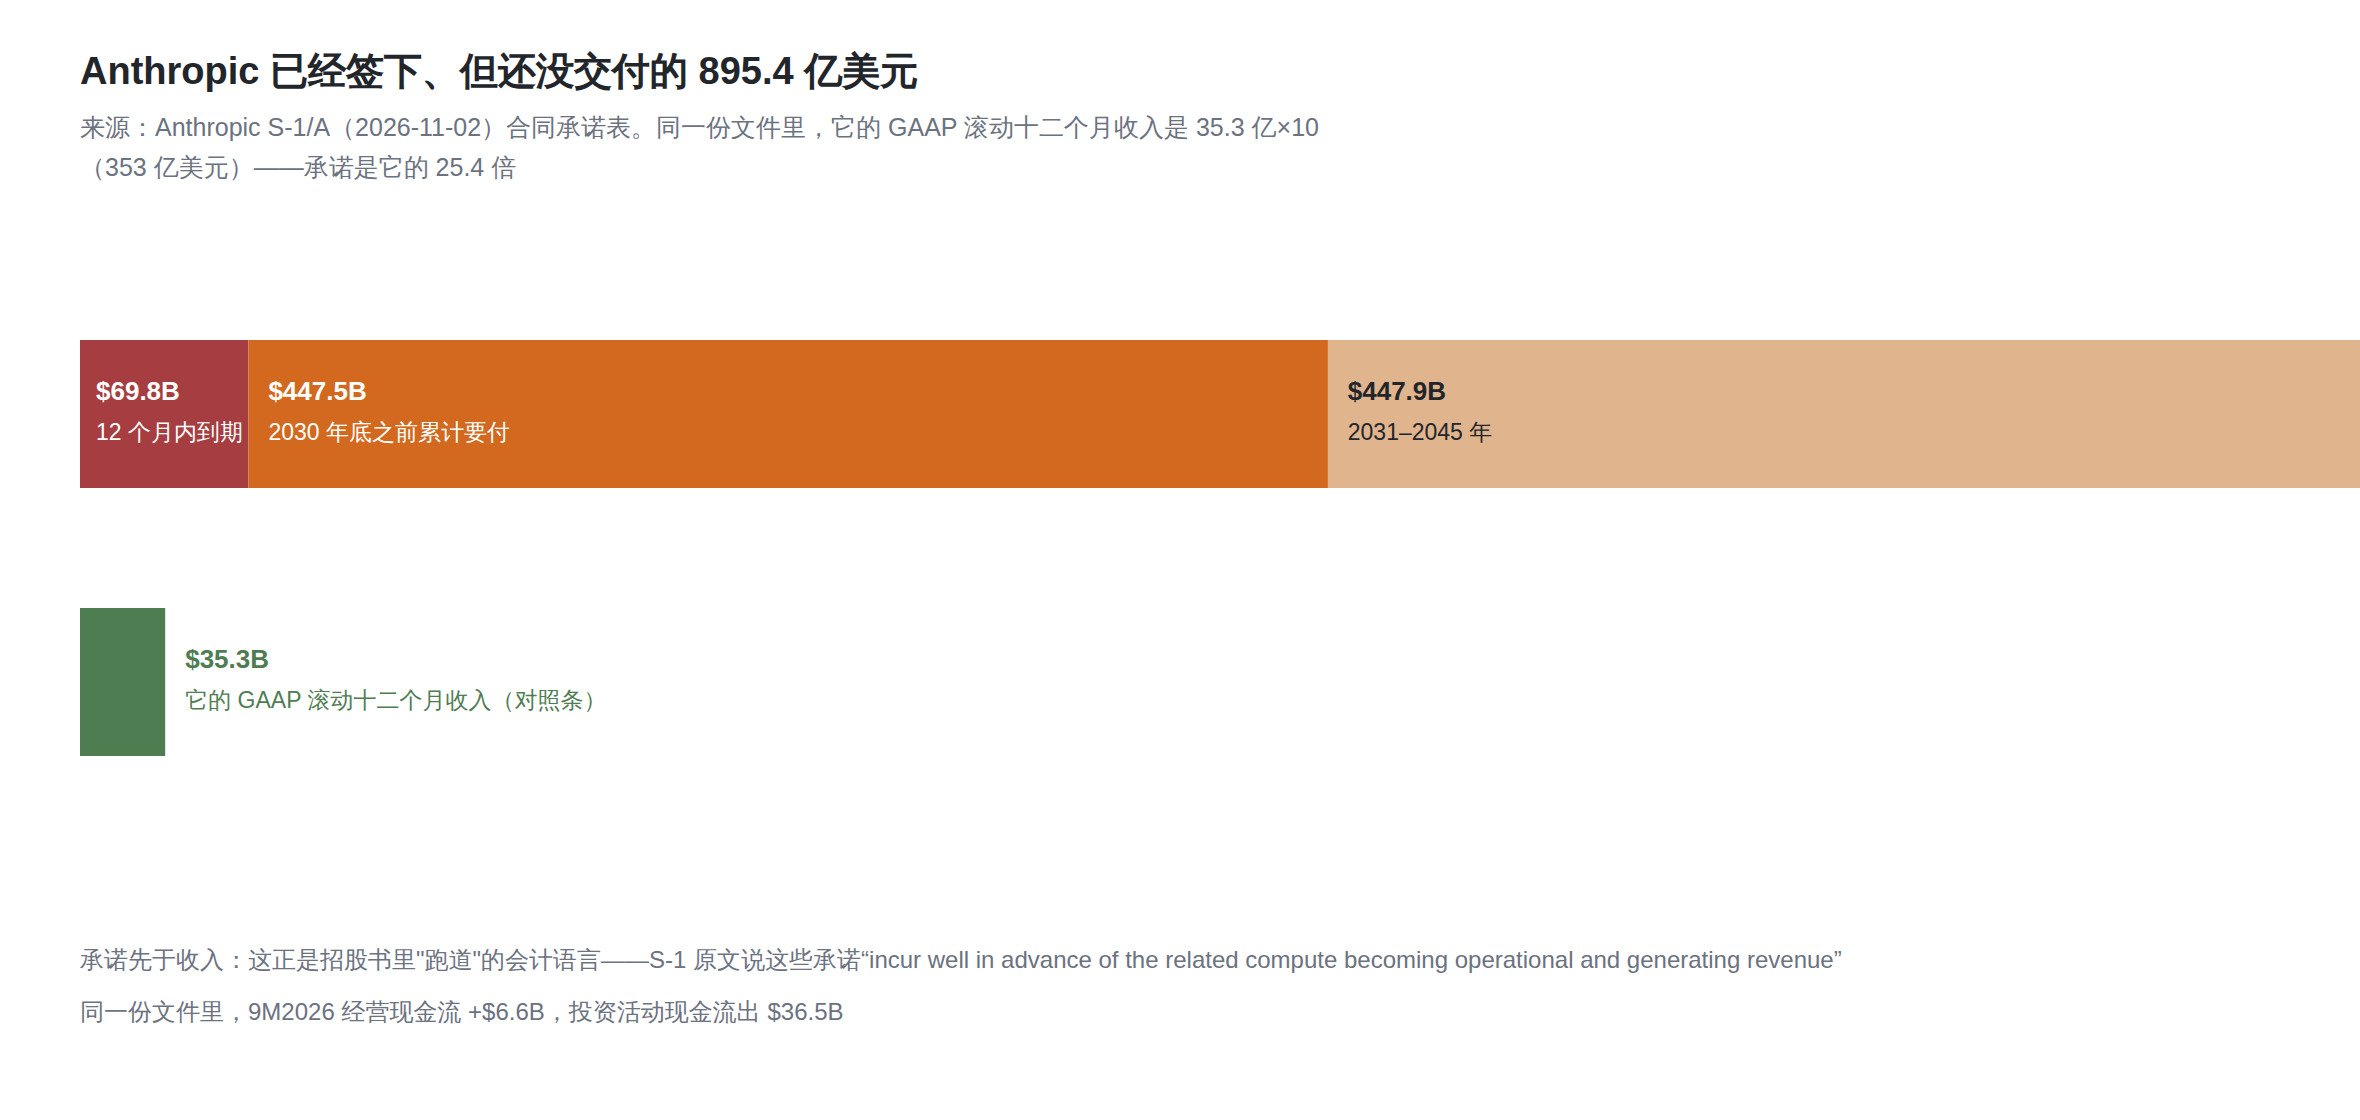
一年几千亿美元的资本开支、上千 TWh 的电、动辄 20 年 1920 兆瓦的购电合同、四家厂商加起来上千亿的融资承诺(OpenAI 1220 亿美元、Anthropic 两轮加起来 950 亿美元)——这些数字摆在 2022 年,会被当成疯话。
下一期我把这张桌子摆一摆:从 2022 年到今天,这个行业投了多少钱、赚回了多少、谁在买单,然后诚实地回答那个问题——这是不是一场泡沫,以及泡沫破了以后会剩下什么。
(这一期的引文核对报告在 反馈/20261103-t-11-sources.md,782 行,每条都有原文、出处和"已核实 / 仅二手 / 未找到"三种状态;我自己的三个实验在 实验/electricity_words.py、实验/ai_invoice.py、实验/machine_energy.py、实验/token_ratio.py,数据在 记录/ 下;两张图在 写作/2026/11/03/。数据截止 2026 年 11 月 3 日。)